流式视频生成:过去与未来
从视频生成到实时交互
在实时交互视频生成中,接下来的画面随着用户输入逐步确定。用户调整镜头方向,模型需要生成新的视角;用户改变提示词,后续画面需要响应新的内容。只要交互还在继续,生成就需要继续。这要求模型根据已有画面和新的输入,及时生成下一步。
CausVid 10 是这条路线的重要起点之一。双向视频扩散在整段视频上联合去噪,当前画面可以借助未来信息;因果生成则把计算沿时间展开,让模型依靠过去生成当前。CausVid 将双向教师的能力蒸馏到少步因果学生中,并通过 KV cache 复用历史计算,把高质量视频模型带向流式输出。
将视频生成沿时间展开之后,模型需要反复根据已有内容预测下一步。这个过程与语言模型的自回归生成相似,但两者存在两个重要区别:生成内容所在的空间,以及每一步推理的计算方式。

首先是离散空间与连续空间的区别。 语言模型从有限词表中选择下一个 token,输出受到离散候选集合的约束。视频扩散则在连续空间中生成视觉内容,没有这样的词表约束。两者都会面临自生成历史带来的误差累积;在视频中,细微的外观、结构或运动偏差,都可能随着生成结果进入下一步的条件,并在反复预测中累积,使画面逐渐漂移。
其次是推理计算的区别。 语言模型在每一步的一次 forward 中,同时构建当前 token 的 KV,并输出下一 token 的预测分布。自回归视频扩散则交替执行两类 forward:在 \(t>0\) 时对带噪输入进行去噪,在 \(t=0\) 时将生成的干净画面写成历史 KV。去噪可能需要多次 forward,而历史写入为下一步生成准备条件。
视频模型的输出不仅需要成为一张好的画面,还会成为后续生成所依赖的历史。 这让当前预测的质量与之后的生成紧密联系起来。
这些特点带来了训练与效率两个问题:怎样组织历史与当前内容,让模型学会接着过去预测;怎样减少每一步的去噪计算,让生成跟上交互。
Teacher Forcing 从真实历史出发训练后续预测,Scheduled Sampling 7 曾探索在训练中混合真实与生成历史。Diffusion Forcing 8 则进一步允许不同位置拥有不同的噪声水平,使序列预测与扩散去噪能够在同一个框架中组织。少步蒸馏解决的是另一个实际问题:即使模型能够按顺序输出,每一步仍然需要足够快,才能接上用户的交互。
训练时使用怎样的历史,尤其重要。Teacher Forcing 提供真实视频中的历史,而推理时,模型面对的是自己此前的输出。真实历史上的预测能力,不能直接代替在自身输出上继续生成的能力。
因此,在真实历史上学会预测,并不意味着模型能够接着自己的输出继续生成。Self Forcing 2 将模型自己生成的历史引入训练:模型通过带 KV cache 的 rollout,接着此前生成的内容继续预测,并接受视频级分布匹配监督。TF 与 SF 都学习根据历史预测当前内容,区别在于训练时使用谁的历史:
其中,\(i\) 表示当前帧或视频块,\(z_i^t\) 是带噪输入,\(\hat{x}_i\) 表示预测的干净内容。两行公式的关键区别在条件项:真实历史 \(x_{<i}^{\mathrm{data}}\) 被替换为模型自身生成的历史 \(\hat{x}_{<i}\)。
这一变化也可以从生成轨迹来理解。将生成与历史写入合在一起,可以写成随机离散动力系统 \(h_i=F_\theta(h_{i-1},\varepsilon_i,u_i)\):\(h_i\) 包含历史 KV 与缓存、位置状态,\(\varepsilon_i\) 表示采样随机性,\(u_i\) 表示提示词或交互输入;\(F_\theta\) 包含当前块的完整采样与缓存更新。模型的每次预测都会改变下一步的条件,局部偏差因此可能随着自回归过程逐渐累积。Self Forcing 让训练沿模型自身产生的历史展开,使监督能够覆盖这些实际生成过程中出现的偏差。

图中的两条曲线示意模型更新前后的生成轨迹。模型先完成自回归 rollout,再通过视频级分布匹配更新参数,随后由更新后的模型重新生成。橙色箭头表示这一训练更新的作用:它改变了模型沿自身历史继续预测的方式,推动生成视频分布接近目标分布。曲线和背景是这一过程的概念性投影。
以 DMD 13 17 为例,这种作用可以理解为视频联合分布诱导的牵引。在带噪视频 \(X_\tau\) 上,理想方向为 \(f_\tau=\nabla_{X_\tau}\log p_\tau-\nabla_{X_\tau}\log q_{\theta,\tau}\),其中 \(p_\tau\)、\(q_{\theta,\tau}\) 分别是目标与学生的带噪视频分布。目标 score 指向更合理的视频区域,学生 score 则校正当前分布的集中位置。它评价整段视频的主体、场景与运动关系,而同一提示词下可以存在许多合理轨迹。
模型会遇到怎样的历史,本身就取决于模型此前的输出。 Self Forcing 将这种反馈关系纳入训练,让模型在自己实际产生的条件下学习后续预测。图中的“牵引”因此发生在参数学习中,推理时仍然由模型自行逐步生成。
走向更好、更长的生成
Self Forcing 将自生成历史纳入训练之后,自回归视频生成仍面临几个问题:学生从怎样的模型起步,短窗口监督怎样覆盖长过程,有限上下文又该如何支持更长的推理?
学生模型需要一个怎样的初始化? Causal Forcing 11 关注的正是这个问题。在少步模型的 ODE 初始化中,双向教师可以利用未来信息,因果学生却只能看到过去和当前输入。如果回归目标依赖学生看不到的内容,同一个可见输入就可能对应不同的目标。Causal Forcing 因此使用自回归教师进行 ODE 初始化,让回归目标与学生能够访问的信息相适应,再进行 Self Forcing 的分布匹配训练。
Causal Forcing++ 12 进一步推进逐帧的 1–2 步生成,通过 causal consistency distillation,利用相邻时间步的在线教师监督学习少步初始化,减少完整 ODE 轨迹的预计算与存储。更少的采样步骤和更细的输出粒度,共同缩短了交互中的等待。
初始化改善了模型的训练起点,但要让视频生成得更长,还需要处理训练时长与推理时长之间的差距。训练窗口时长有限,因为直接延长训练窗口会增加时空 token 和中间状态的数量,带来更高的显存占用与计算开销,而现有短视频教师的可靠监督范围也受到训练时长限制。而实际交互却可能持续几分钟甚至几个小时,远超训练能够直接覆盖的时间范围。
如何用短窗口监督,训练更长的生成过程? LongLive 4 通过 streaming long tuning,让模型沿自身生成的历史逐段继续,并用短视频教师监督每一段,同时通过短窗口注意力与 frame sink 控制计算成本、保留历史锚点。Self-Forcing++ 5 则从模型生成的长视频中抽取片段进行蒸馏,让短视频教师的监督覆盖更长的生成轨迹。两种方法都将长过程拆成教师能够评价的局部,让有限范围的监督作用于更长的自生成轨迹。但训练中更长的自回归展开也带来了额外的训练开销,分段监督还需要处理 VAE 时序编解码中复杂的边界问题。
有限的上下文,如何支撑更长的视频推理? 随着推理时长增加,模型无法始终保留并读取全部历史,需要在有限的缓存预算内选择有用的信息。Deep Forcing 6 保留早期历史作为锚点,并根据近期预测的注意力筛选历史 KV,减少冗余内容,让有限缓存更有效地支持后续生成。Infinity-RoPE 14 则在已训练的模型上从时间位置编码入手,无需额外训练,通过随生成推进的局部坐标系组织历史与当前内容,避免时间位置不断增长、超出模型原有的编码范围。两者分别从历史选择与位置编码入手,改善长程推理中的上下文使用。
这些方向作用于不同环节:初始化决定学生的起点,长程训练扩展模型经历过的生成轨迹,历史选择决定每一步保留哪些信息,位置编码则组织这些信息与当前预测的时间关系。

让未来损失监督历史的学习
前面的工作从模型的初始化、长程训练、历史选择和位置编码等方面改善了自回归视频生成。但当推理时长超出训练窗口后,仍然会出现明显的误差累积,表现为画面漂移、崩坏等现象。SGF 将其中一个问题定位到历史表征的学习:在 SF 的 KV 梯度截断设置中,模型学习如何利用历史,历史写入却缺少未来损失的直接监督。
历史画面需要被编码为 KV 表征,才能供后续生成读取。但历史参与了预测,并不意味着构建历史的过程也获得了监督。如果历史 KV 被作为固定条件,后续损失可以指导模型如何利用它们,却无法沿这条路径指导模型如何构建它们。
要看清这一区别,可以把模型的计算分为两部分:读取历史 KV,对当前内容去噪;将生成画面写成新的 KV,供后续预测使用。
将已有的历史缓存记为 \(\mathrm{KV}_{<i}\),这两种计算分别写为:
两行公式使用同一套参数 \(\theta\),但承担不同职责:第一行在 \(t>0\) 时利用历史对当前内容去噪,第二行在 \(t_{\mathrm{ctx}}=0\) 时将干净画面写成历史 KV。历史 KV 将两种计算连接起来,而梯度是否经过第二行,决定了未来损失能否训练历史写入。
在 Self Forcing 中,这条写入路径被截断梯度,历史 KV 作为固定条件供后续预测使用。停止历史梯度,并不意味着写入器保持不变。 以一次 SGD 更新为例,对同一历史输入,\(t=0\) 的写入结果一般会随共享参数变化:
初始化继承的写入能力因此可能漂移、衰退,而被截断的 KV 路径使未来损失无法直接纠正这种变化。
Self Gradient Forcing(SGF)3 恢复了这条路径,让未来损失能够监督历史表征的构建。它既让 writer 适应自生成历史,也为持续变化的写入能力补上反馈。它与 SF 的区别,可以直接从停止梯度的位置看出来:
\(\operatorname{sg}\) 表示停止梯度。SF 将整个 KV 构建过程放在停止梯度的范围内;SGF 则只固定已经生成的画面,让构建 KV 的计算继续参与学习。这样,同样一段历史就能根据后续预测的需要,被编码为更有用的表征。
为了实现这一梯度路径,SGF 将训练分为两遍。第一遍执行无梯度 rollout,记录生成画面与选定退出步的输入。第二遍通过因果掩码并行重建历史 KV 与当前预测,并匹配 rollout 的注意力和位置关系。生成画面与采样轨迹保持停止梯度,构建历史 KV 的计算则参与反向传播。这样既保留模型实际遇到的历史,又避免为完整串行采样过程保留反向计算图。
SGF 在短窗口内学习如何构建有助于未来预测的历史表征,并在更长的推理过程中反复使用这一写入机制。论文在相同初始化、五秒训练窗口和缓存协议下比较 SF 与 SGF:短视频表现整体相近,60 秒与 240 秒的多数质量和一致性指标得到改善。这些对照实验表明,更充分地训练历史表征的构建,就能显著改善长程外推,无需延长训练窗口、增加训练数据、额外设计 KV cache,或引入新的损失函数。
恢复历史写入的梯度后,SGF 改善了长时间生成的一致性,但也出现了一个现象:少量样例中,SGF 的首帧相比 SF 出现了轻微模糊。
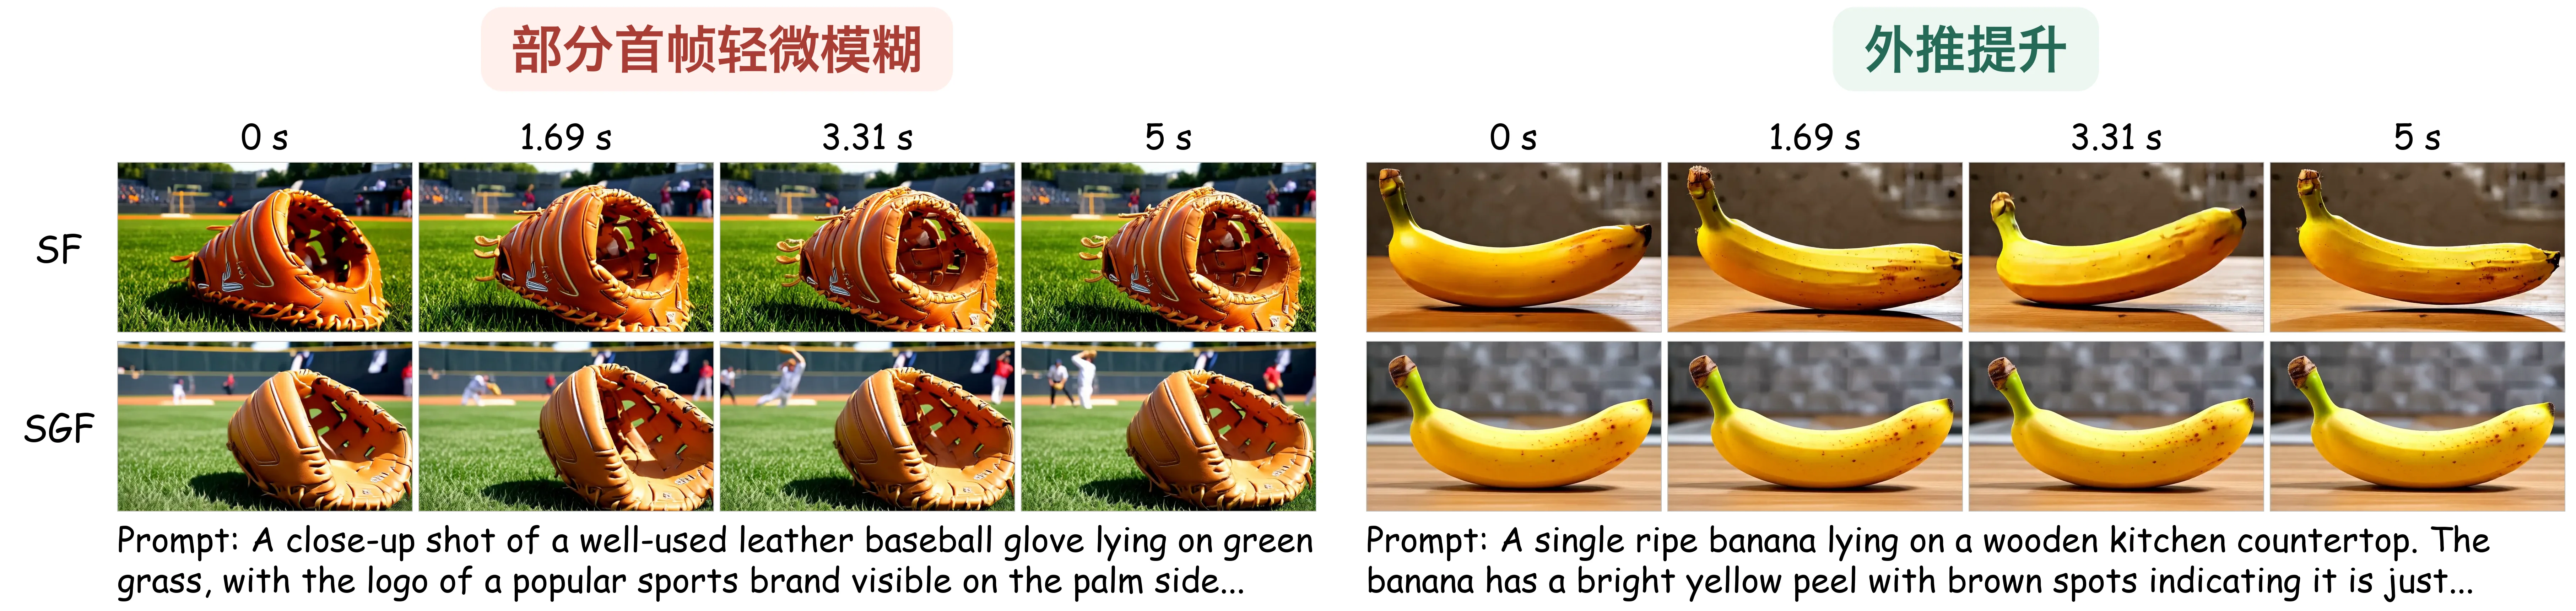
首帧还没有历史视频 KV 可以读取,它的质量变化提供了一个线索:用于学习历史表征的梯度,是否会与当前画面去噪的梯度相互干扰?
式(2)中的两种计算共享参数。因此,恢复历史写入的梯度后,参数更新同时受到上下文写入与当前去噪的影响。将同一生成损失沿这两条路径产生的梯度贡献分别记为 \(g_{\mathrm{context}}\) 和 \(g_{\mathrm{denoise}}\),它们共同构成共享参数的梯度,其方向关系可以用余弦相似度衡量:
当两种梯度非零且 \(s<0\) 时,它们在方向上存在冲突:有利于一种角色的更新,可能不利于另一种角色。两者相加时,会在相反的方向分量上发生抵消。
Self Gradient Forcing Plus(SGF+)1 据此在 Wan2.1 15 模型上分别测量两种角色的梯度贡献,并计算配对余弦相似度。在 128 个 prompts、4 个退出步上,所测 Attention 与 FFN 权重各得到 512 对梯度,配对余弦均为负,说明历史写入与当前去噪对共享参数的更新存在冲突。两种贡献相加时会部分抵消,使两种角色难以同时得到充分优化。
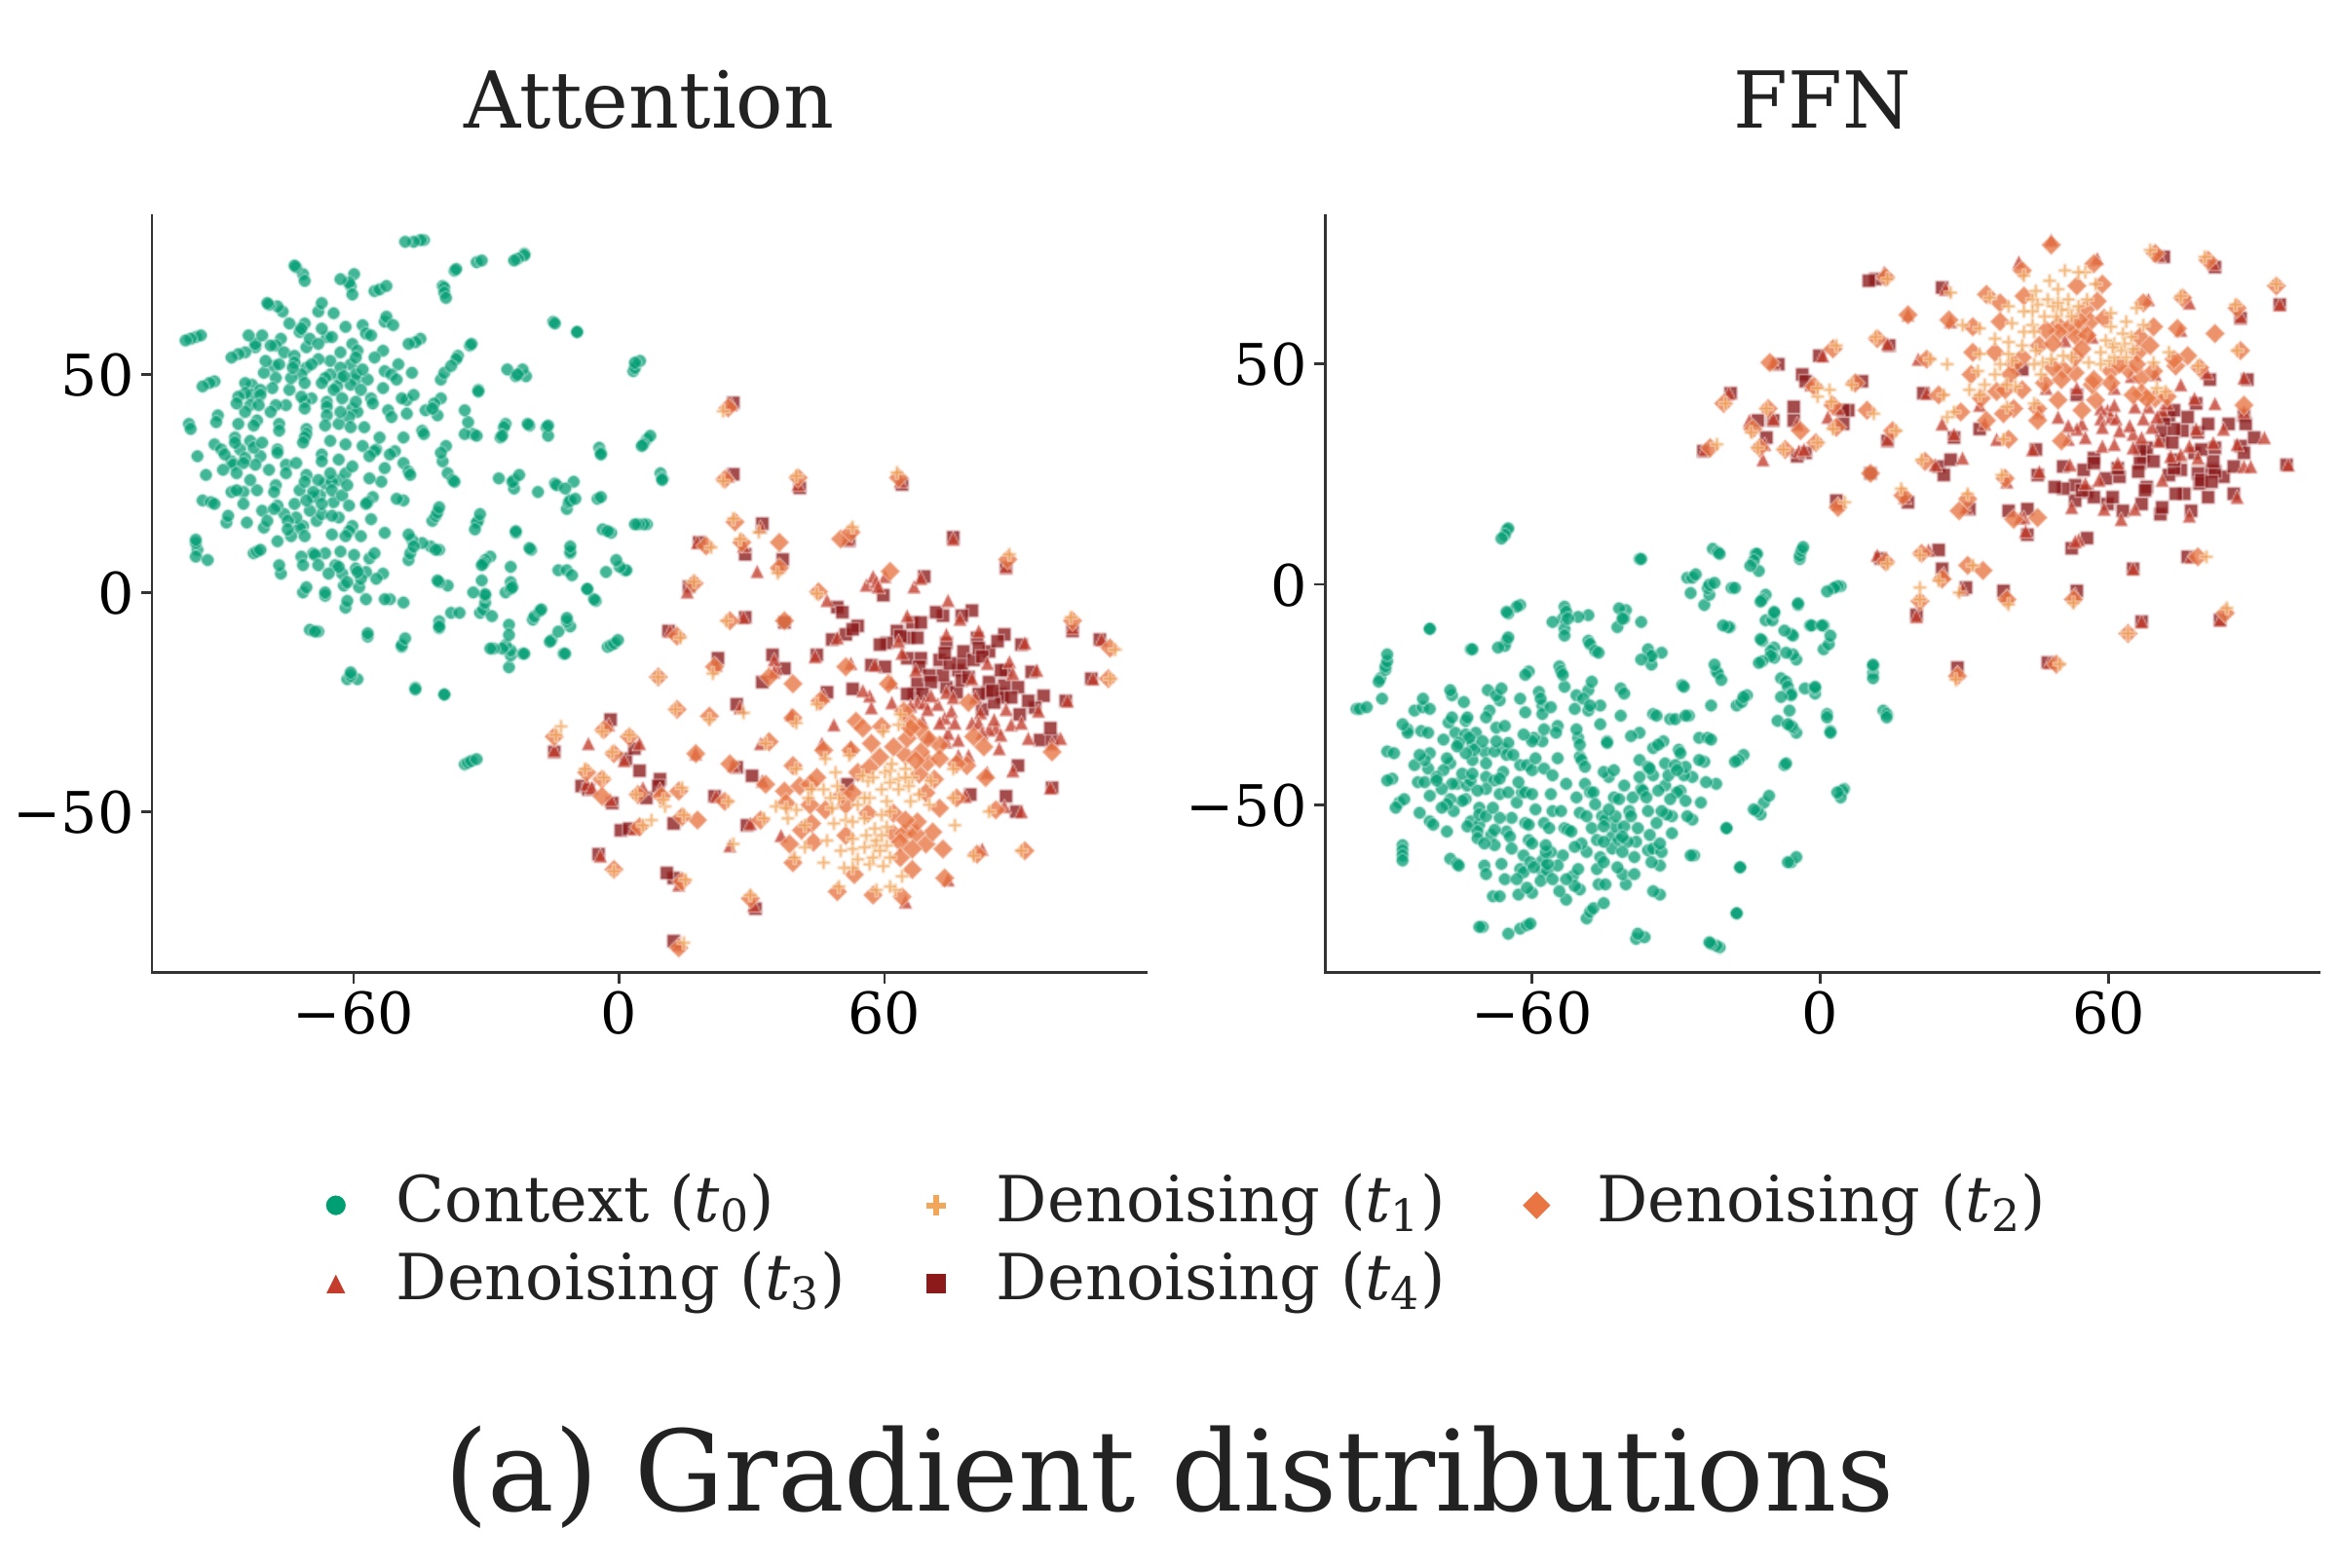
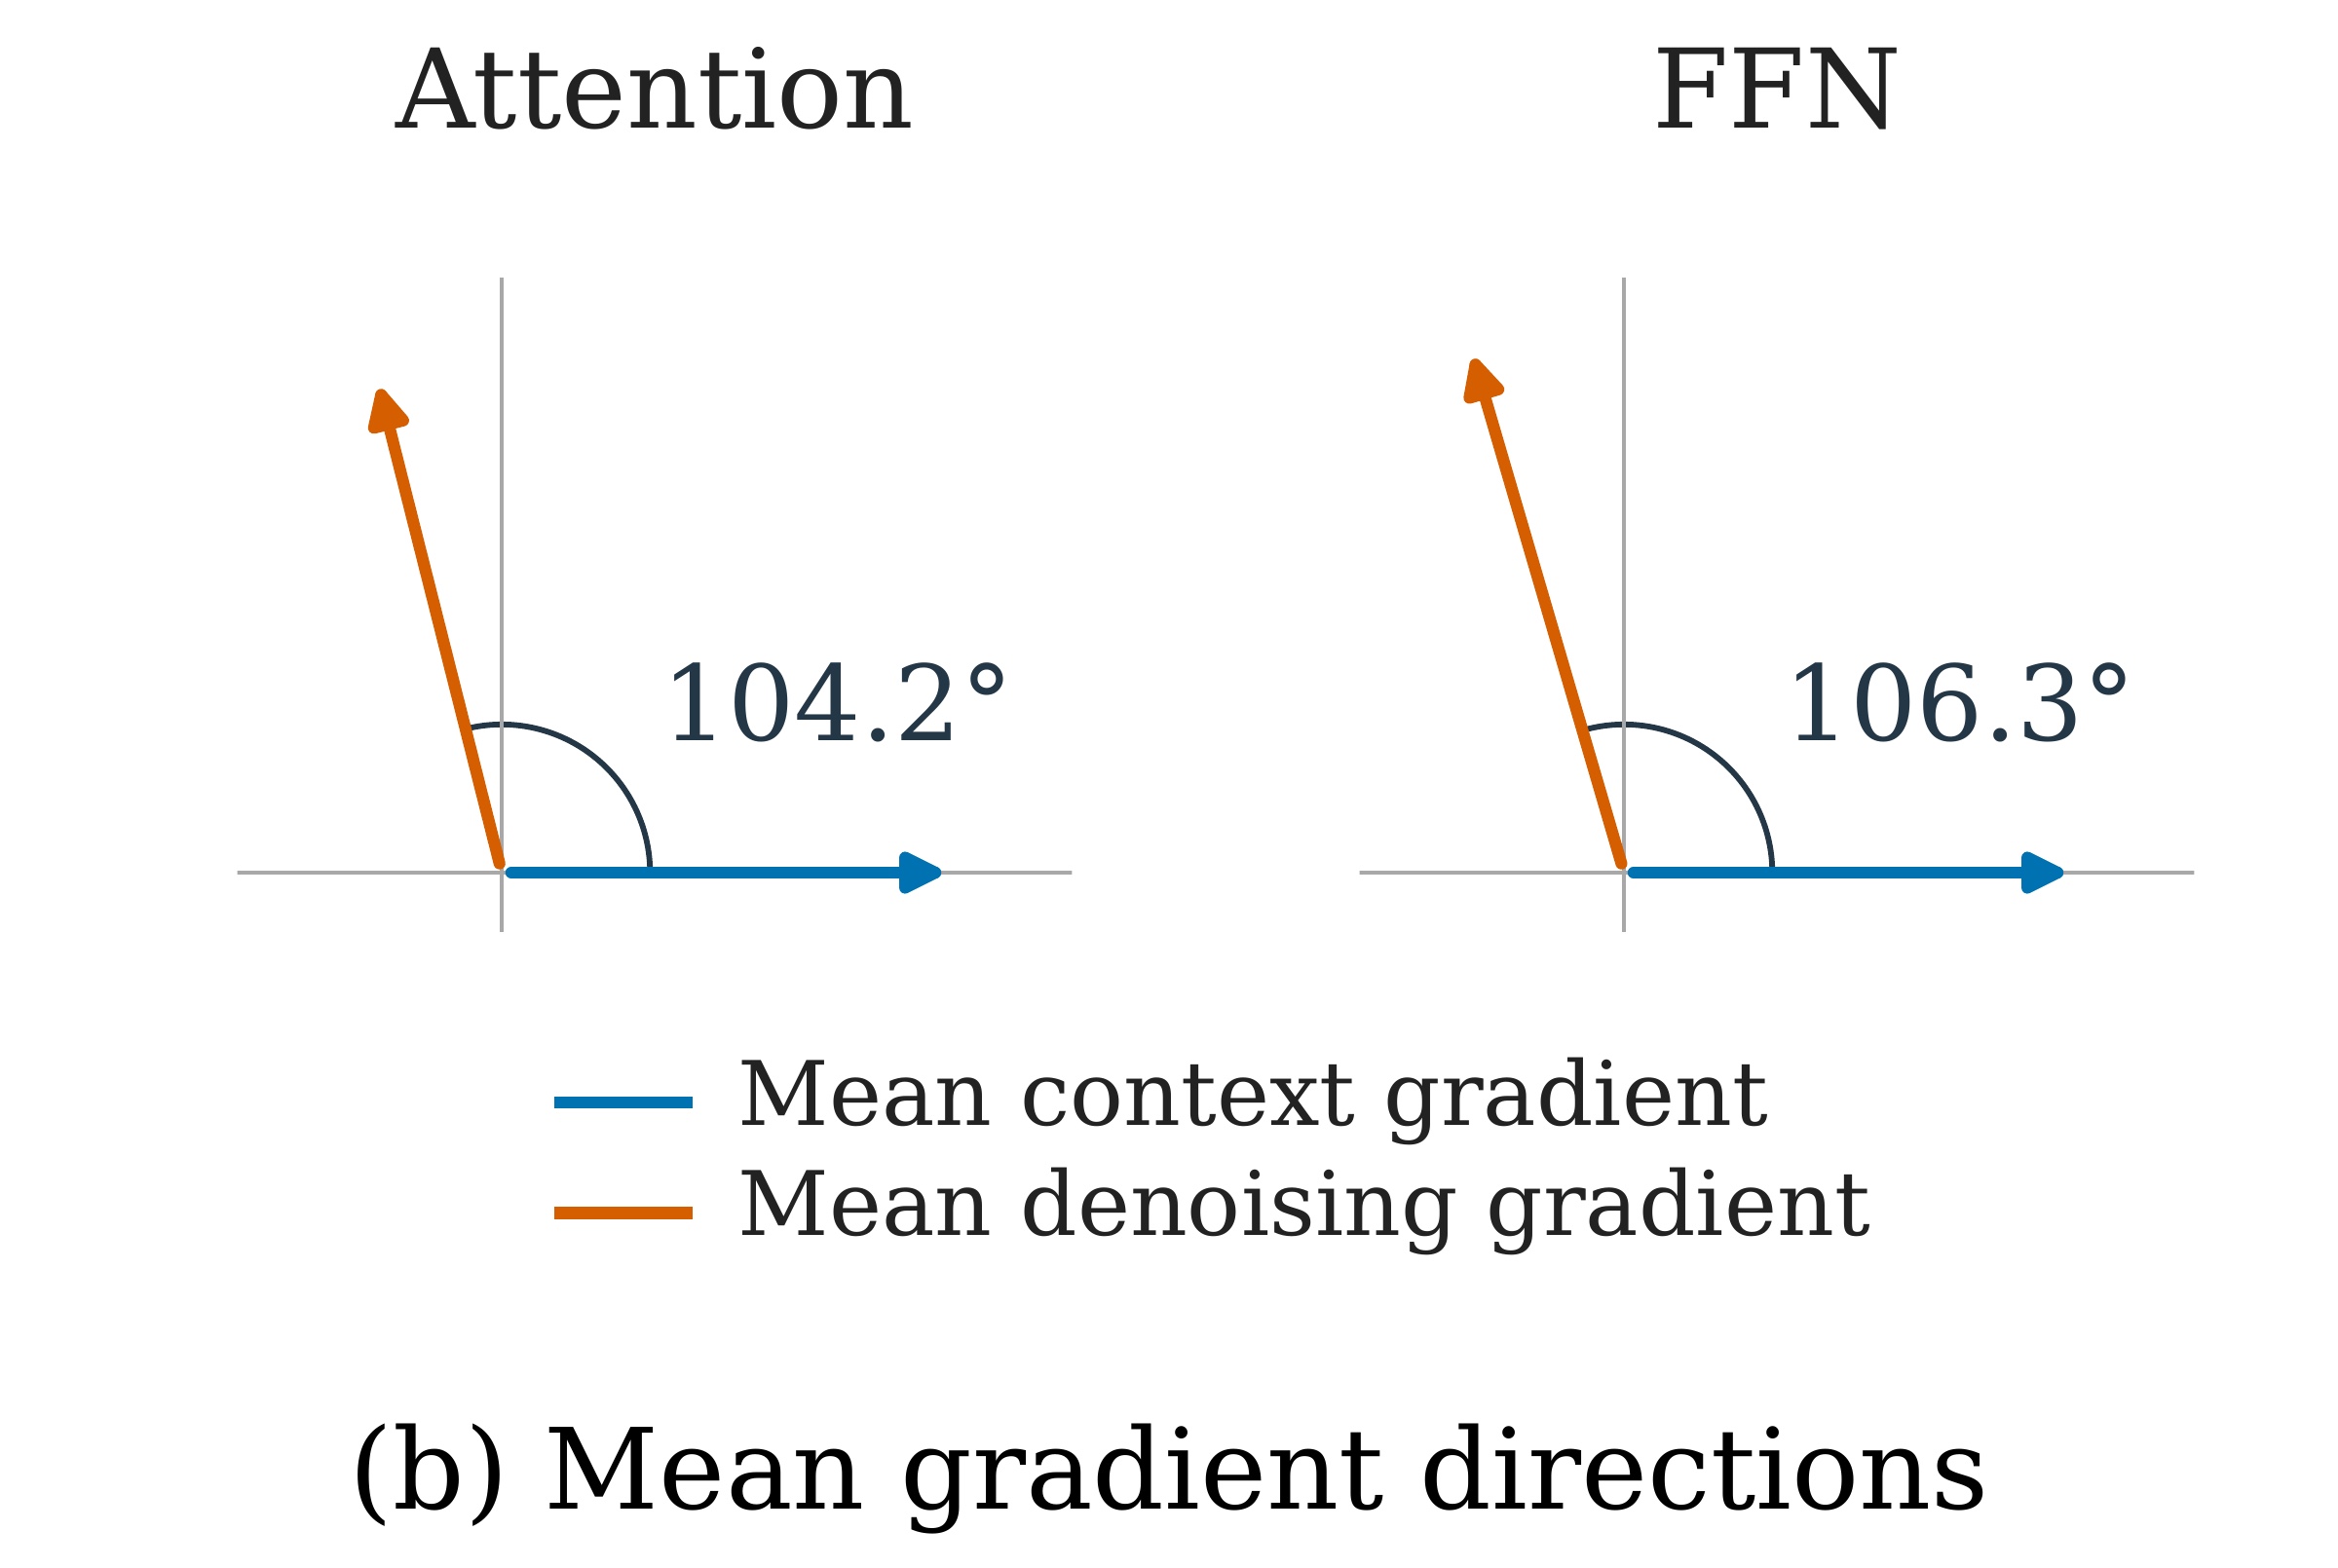
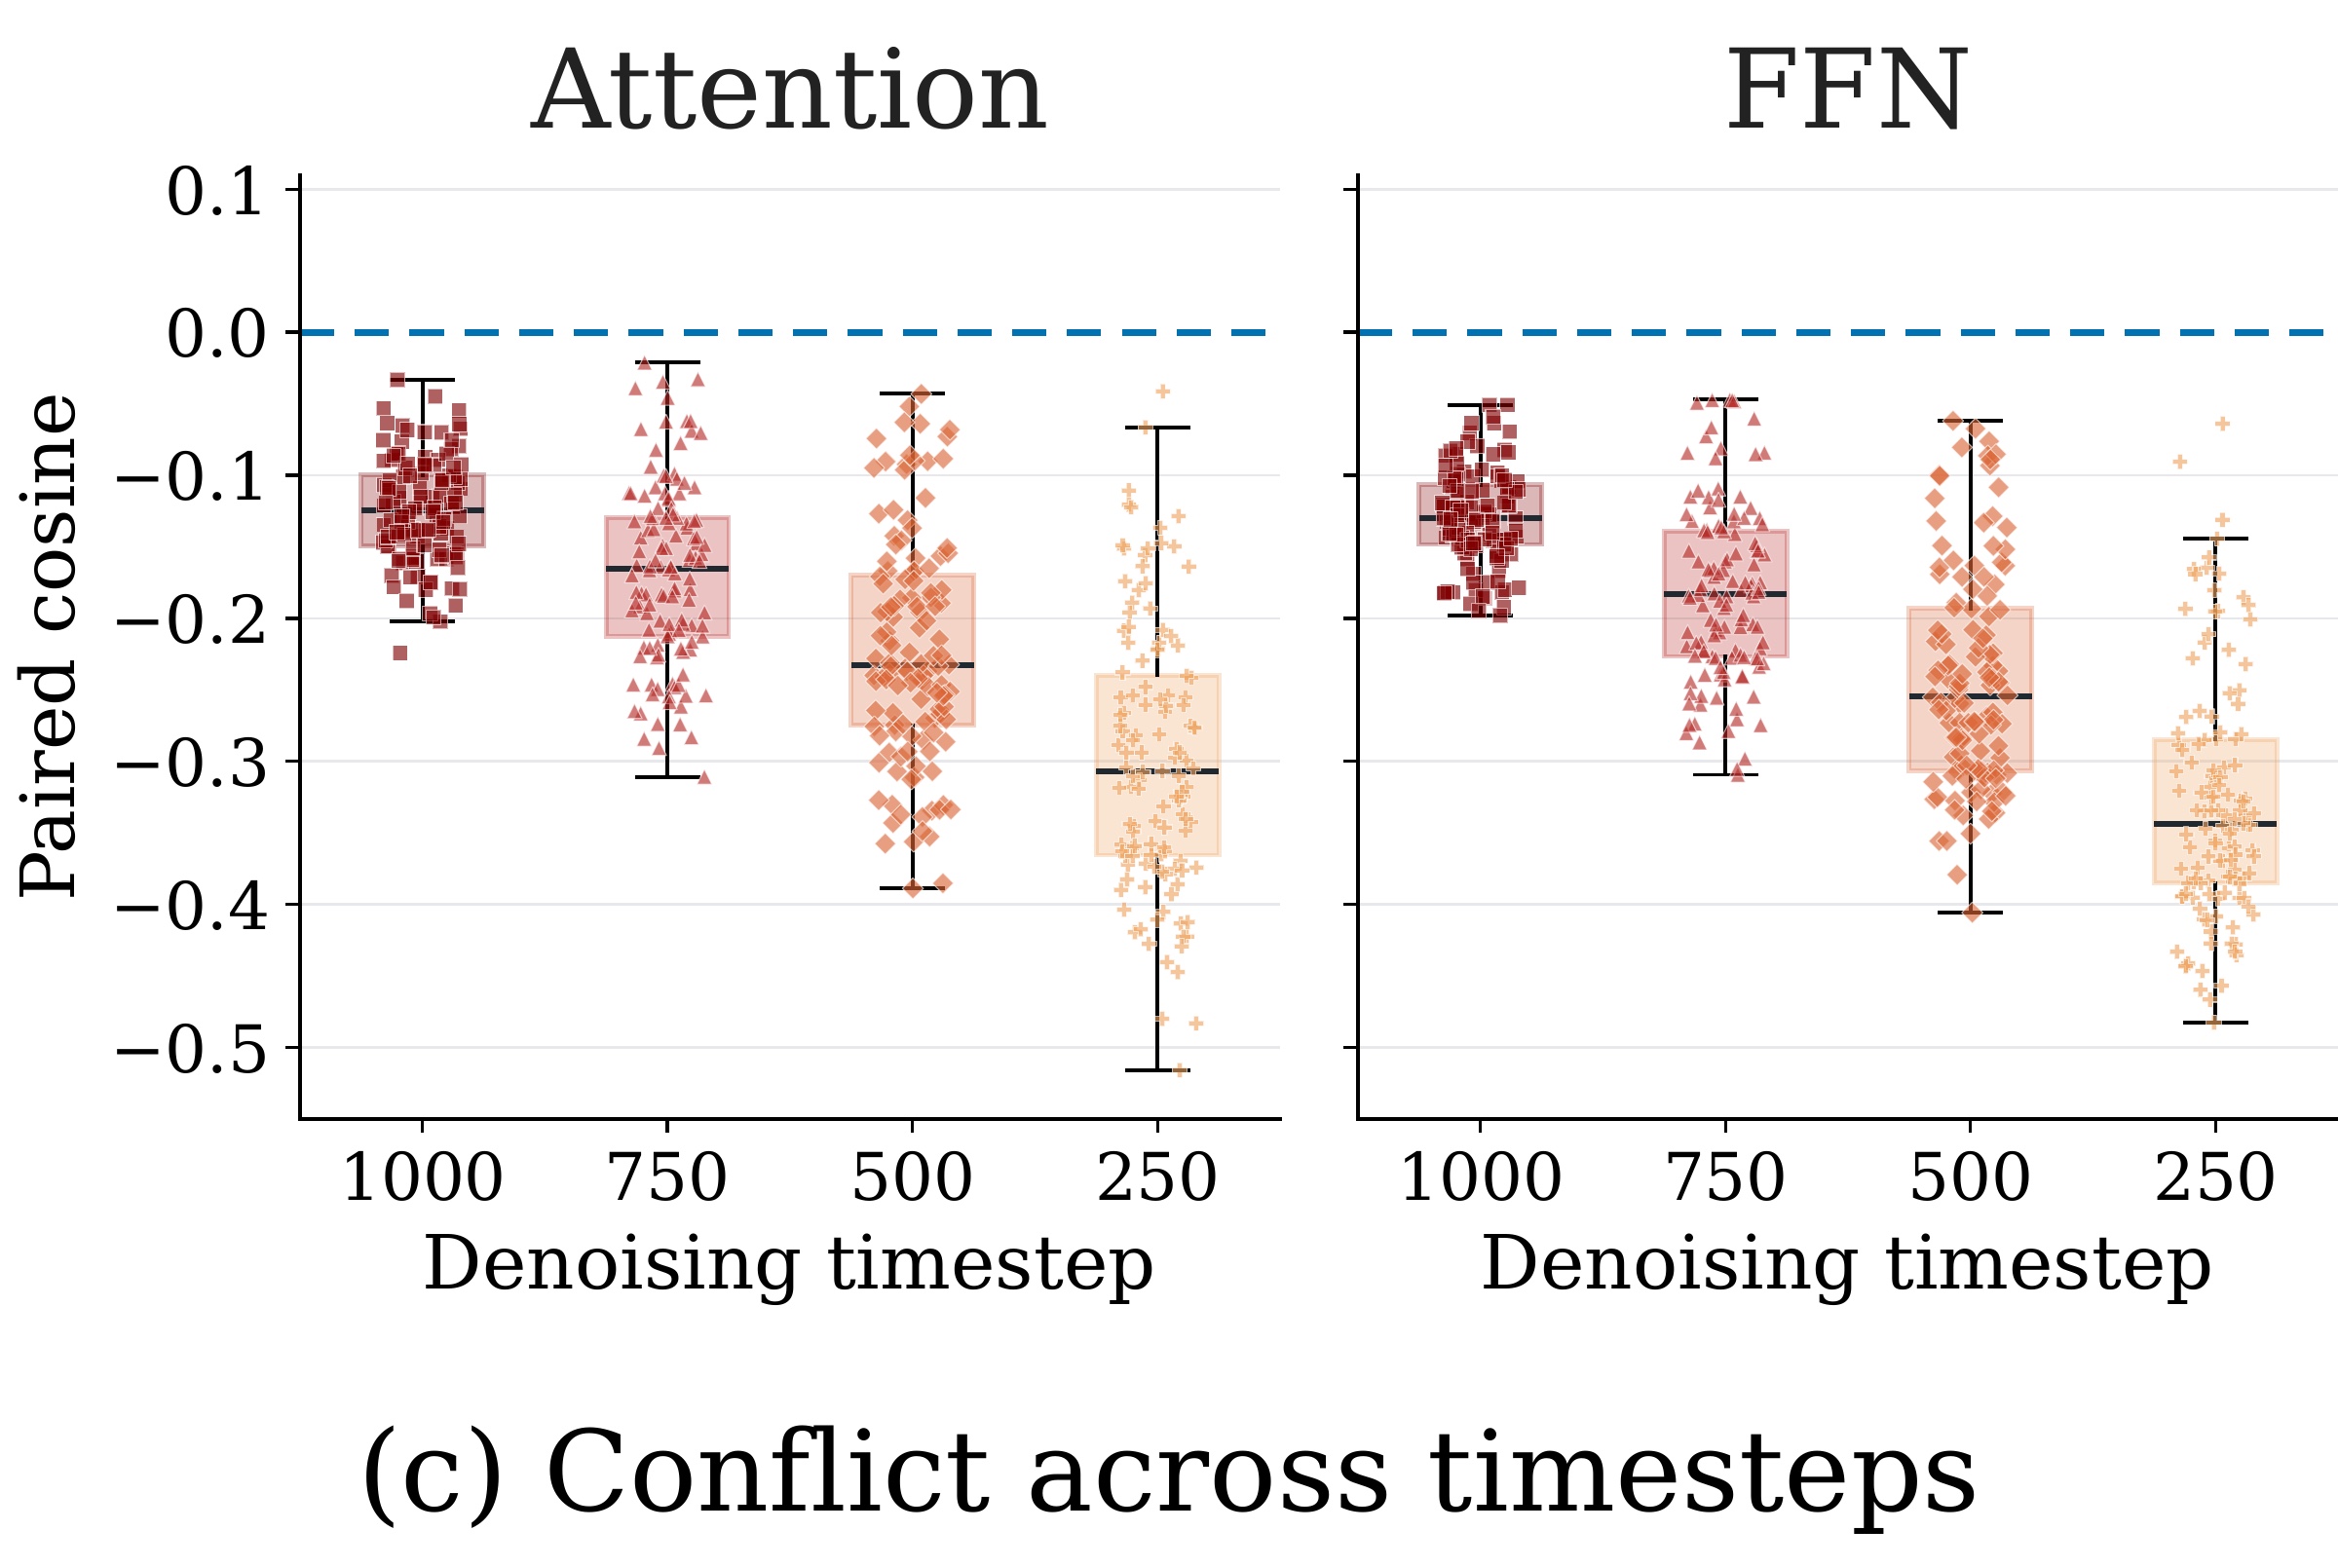
我们进一步在参数规模达 22B 的 LTX-2.5 16 上进行了补充测量。下面的热力图显示,多数层与噪声水平组合的平均配对梯度余弦仍为负,且冲突强度随层位置和噪声水平变化。这说明,写入与去噪的梯度冲突在更大规模的模型中依然存在。
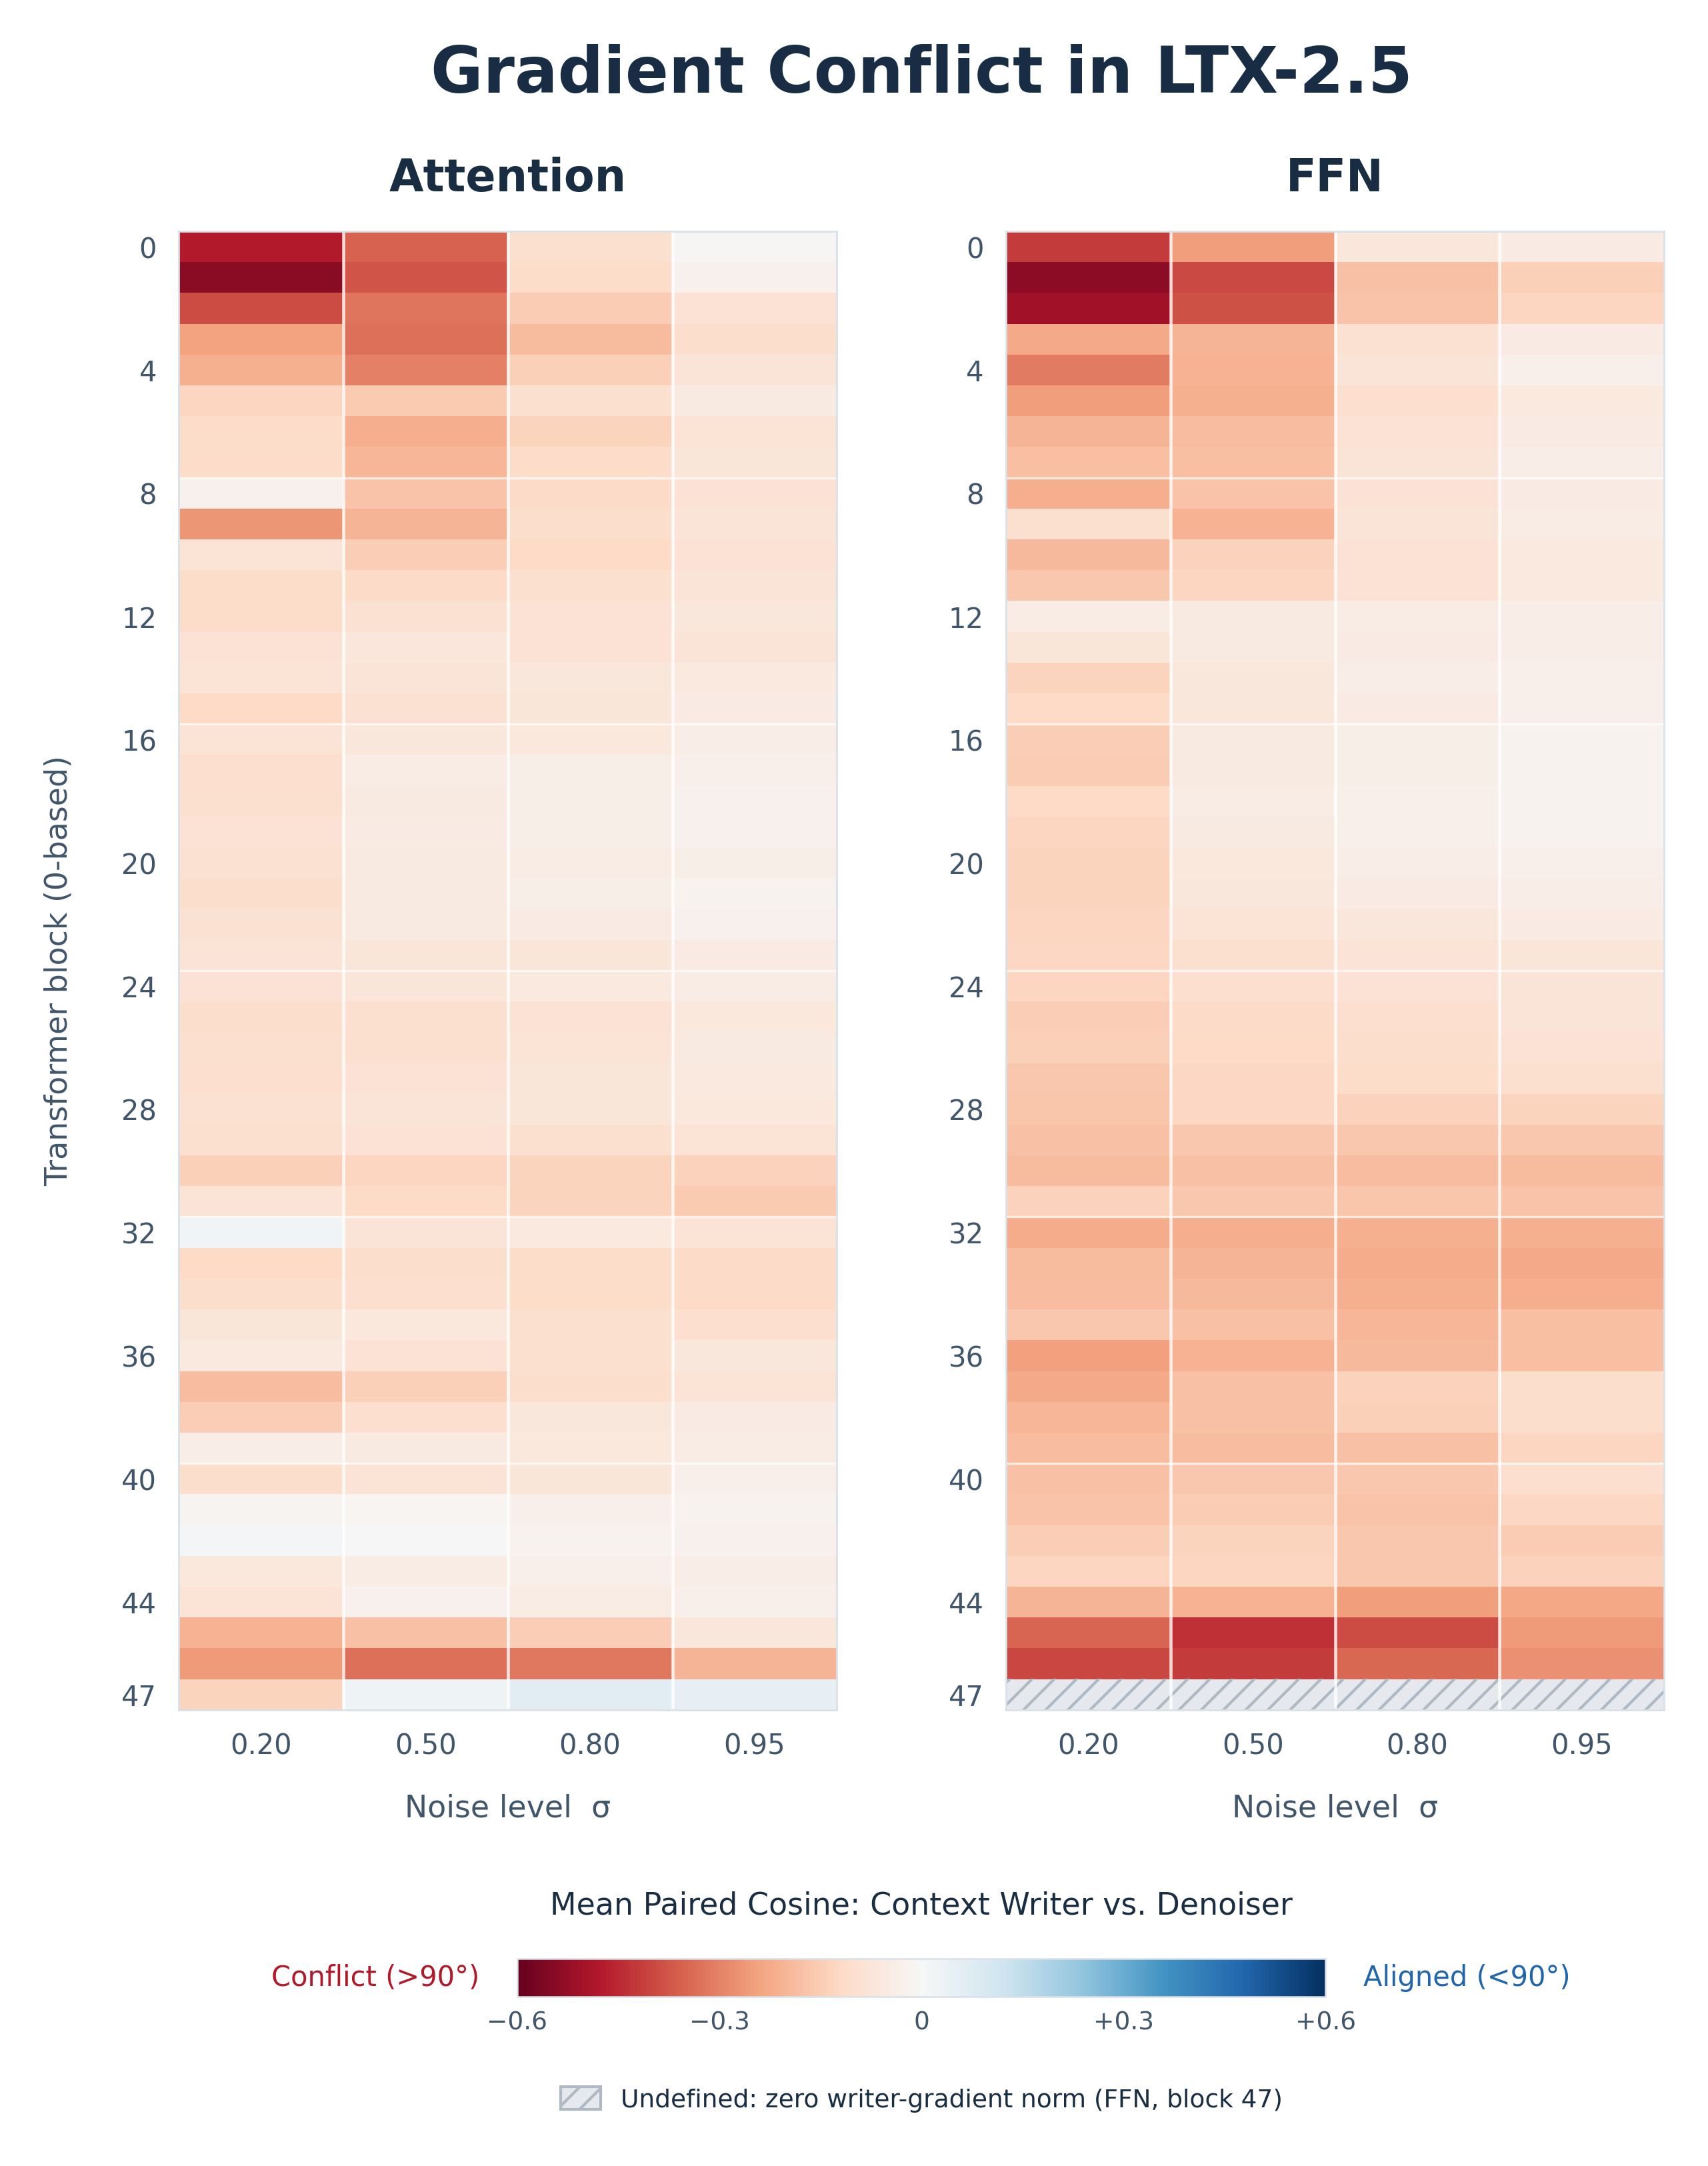
这里更深的一点是:同一个目标,不要求两种角色以相同方式改变。 在固定 replay 的局部分析中,若 \(g_{\mathrm{context}}=-g_{\mathrm{denoise}}\ne0\),共享梯度会相互抵消,但两个角色分别仍有下降方向。共享权重限制了这种分别适应的可能。
基于这一观察,SGF+ 将式(2)中共享的模型分为上下文写入模型 \(\mathcal C_{\theta_c}\) 与去噪模型 \(\mathcal D_{\theta_d}\)。两者分别负责历史表征的构建与当前画面的生成:
与式(2)相比,两种计算不再共享参数;与式(3)中的 SGF 相同,生成画面仍然保持停止梯度,历史 KV 的构建过程仍然可以学习。
参数分离并没有切断两种角色的联系。损失直接更新去噪模型,也通过它对历史 KV 的依赖,继续监督上下文写入模型。两者仍由同一个生成目标联合训练,但可以分别优化各自的参数。
在 framewise 和 chunkwise 设置下,SGF+ 进一步改善了多数视觉质量与长程一致性指标,并在五秒训练窗口下展示四个 24 小时连续生成案例,无需长视频微调。系统量化评测覆盖 60 秒与 240 秒,24 小时案例则展示了更长的连续运行跨度。参数分离增加了权重存储,但两类调用原本就存在;在论文的 81 帧负载下,SGF 与 SGF+ 的推理耗时分别为 4.962 秒和 4.969 秒。
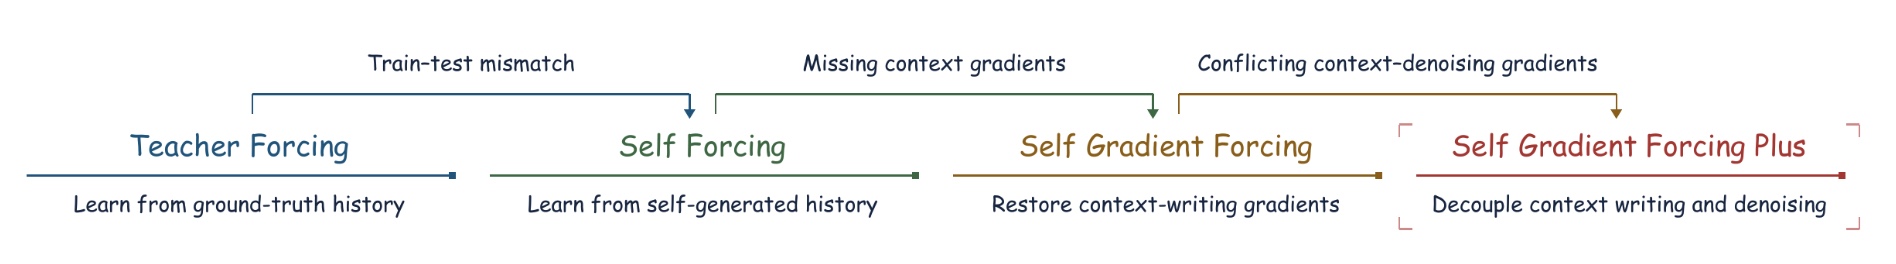
从 SGF 到 SGF+,历史表征的监督与参数分工逐步被纳入训练。SGF 让未来损失能够训练历史写入,SGF+ 则进一步处理这部分学习与当前去噪之间的冲突。这两步设计围绕同一个问题展开:怎样让模型留下对未来生成更有用的过去。
这条研究脉络涉及训练本身的两个基本选择:损失能够训练哪些计算,以及不同职责是否必须共享同一组参数。 SGF 和 SGF+ 保留自生成历史、视频生成目标与 KV 读写接口,分别调整梯度路径和参数共享约束,让已有的任务监督更充分地作用于整个生成过程。更长的训练让模型经历更多状态,而这两步改进让模型能从同样的经历中学到更有用的历史表示;它们也可以与初始化、长程训练和缓存设计共同作用。
一些思考
历史写入与当前去噪通过 KV 紧密联系,但这种协作并不要求它们使用完全相同的权重。角色分离由此引出了三个值得继续探索的问题。
与 GPT/LLM 的联系。 同样是自回归生成,哪些计算差异使视频模型值得重新考虑参数共享?语言理解与生成已广泛在统一的 token 预测框架下建模,而视觉理解与生成如何统一,仍有许多开放问题。从计算过程看,GPT 在一次前向计算中构建 KV 并预测下一个 token,自回归视频扩散则交替执行 t=0 的上下文写入与 t>0 的去噪生成。上下文写入需要提取供未来预测使用的历史信息,去噪生成需要从带噪输入中恢复当前画面。这些输入状态与计算角色的差异,可能使共享参数面临不同、甚至冲突的优化需求。
参数分离也可以从更早的阶段开始。 TF 初始化模型中已经可以观察到角色梯度的差异和负向对齐,说明上下文写入与去噪的冲突并不是到 SGF 训练后才出现。因此,值得进一步检验将角色分离前移到 TF 阶段的效果,让模型从初始化训练开始,就分别学习如何构建历史表征、如何利用历史完成预测。这一思路也可以拓展到世界动作模型(World Action Model)。采用 Teacher Forcing 训练的世界动作模型,为这一方向提供了应用场景。将上下文写入与视觉、动作预测分开,可能有助于模型更有效地学习服务于后续预测的历史表征。
轻量 writer、独立 memory 与 KV 压缩。 角色分离使模型可以按需分配容量,为上下文写入与去噪采用不同规模的网络。进一步可以围绕 writer 探索独立的 memory 设计:如何组织、写入和更新历史,例如分层保留近期细节与长期信息,或选择性写入关键事件。这些记忆再通过与 denoiser 兼容的 KV 接口参与后续生成。
一个值得探索的方向是使用轻量写入器,在有限的缓存预算下,将冗余的视频历史压缩为供后续预测使用的 KV 表征。训练时可以固定去噪器参数,保持其读取历史 KV 的方式不变,通过未来生成损失优化可学习的写入与压缩模块。目标是在保持生成质量与长程一致性的同时,降低参数存储、KV 缓存占用和注意力计算开销。
迈向无限外推的视频生成
用户不会按照训练片段的长度结束一次交互。理想的流式视频生成,应当允许用户边看边调整,让生成随着交互继续。
SGF 与 SGF+ 从历史表征的学习出发,探索了短窗口训练支持长程外推的一条路径。接下来,仍有两个值得追问的问题:有限的训练窗口,究竟能支撑多长的生成?有限的记忆,又该为未来留下什么?
“Det er ganske sandt, hvad Philosophien siger, at Livet maa forstaaes baglænds. Men derover glemmer man den anden Sætning, at det maa leves forlænds.”
人生须在回望中理解,却须在前行中度过。
参考文献
- Su, Z., Zhuang, J., Li, Y., et al. SGF+: Decoupling Gradient Flows for Autoregressive Video Generation. arXiv:2610.10429v2, 2026. https://arxiv.org/abs/2610.10429v2
- Huang, X., Li, Z., He, G., Zhou, M., and Shechtman, E. Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion. arXiv:2506.08009, 2025. https://arxiv.org/abs/2506.08009
- Zhuang, J., Zhang, S., Bian, Y., et al. Self Gradient Forcing: Native Long Video Extrapolation. arXiv:2607.20368v2, 2026. https://arxiv.org/abs/2607.20368v2
- Yang, S., Huang, W., Chu, R., et al. LongLive: Real-time Interactive Long Video Generation. arXiv:2509.22622, 2025. https://arxiv.org/abs/2509.22622
- Cui, J., Wu, J., Li, M., et al. Self-Forcing++: Towards Minute-Scale High-Quality Video Generation. arXiv:2510.02283, 2025. https://arxiv.org/abs/2510.02283
- Yi, J., Jang, W., Cho, P. H., et al. Deep Forcing: Training-Free Long Video Generation with Deep Sink and Participative Compression. arXiv:2512.05081, 2025. https://arxiv.org/abs/2512.05081
- Bengio, S., Vinyals, O., Jaitly, N., and Shazeer, N. Scheduled Sampling for Sequence Prediction with Recurrent Neural Networks. 2015. https://arxiv.org/abs/1506.03099
- Chen, B., Martí Monsó, D., Du, Y., et al. Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion. 2024. https://arxiv.org/abs/2407.01392
- Dai, Z., Yang, Z., Yang, Y., et al. Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context. 2019. https://arxiv.org/abs/1901.02860
- Yin, T., Zhang, Q., Zhang, R., et al. From Slow Bidirectional to Fast Autoregressive Video Diffusion Models. CVPR 2025. https://arxiv.org/abs/2412.07772
- Zhu, H., Zhao, M., He, G., et al. Causal Forcing: Autoregressive Diffusion Distillation Done Right for High-Quality Real-Time Interactive Video Generation. 2026. https://arxiv.org/abs/2602.02214
- Zhao, M., Zhu, H., Zheng, K., et al. Causal Forcing++: Scalable Few-Step Autoregressive Diffusion Distillation for Real-Time Interactive Video Generation. 2026. https://arxiv.org/abs/2605.15141
- One-step Diffusion with Distribution Matching Distillation. arXiv:2311.18828, 2023. https://arxiv.org/abs/2311.18828
- Yesiltepe, H., Meral, T. H. S., Akan, A. K., Oktay, K., and Yanardag, P. Infinity-RoPE: Action-Controllable Infinite Video Generation Emerges From Autoregressive Self-Rollout. arXiv:2511.20649, 2025. https://arxiv.org/abs/2511.20649
- Wan Team. Wan: Open and Advanced Large-Scale Video Generative Models. arXiv:2503.20314, 2025. https://arxiv.org/abs/2503.20314
- Lightricks. LTX-2.5. Official model card, 2026. https://huggingface.co/Lightricks/LTX-2.5
- Improved Distribution Matching Distillation for Fast Image Synthesis. arXiv:2405.14867, 2024. https://arxiv.org/abs/2405.14867
引用
@article{su2026sgf+,
  title={SGF+: Decoupling Gradient Flows for Autoregressive Video Generation},
  author={Su, Zihan and Zhuang, Junhao and Li, Yaowei and Lu, Siwen and Li, Haoran and Li, Lingen and Wu, Haoyu and Jin, Weiyang and Zhang, Songchun and Huang, Haoyang and others},
  journal={arXiv preprint arXiv:2610.10429},
  year={2026}
}

@article{zhuang2026self,
  title   = {Self Gradient Forcing: Native Long Video Extrapolation},
  author  = {Zhuang, Junhao and Zhang, Shiyi and Bian, Yuxuan
             and Li, Yaowei and Luo, Yawen and Liu, Yijun
             and Jin, Weiyang and Zhang, Songchun and He, Xianglong
             and Zhang, Xuying and others},
  journal = {arXiv preprint arXiv:2607.20368},
  year    = {2026}
}